Spec-Driven Development & Agentic AI Software Engineering
In diesem Artikel zeigen wir einen vollständigen KI-gestützten Softwareentwicklungsprozess – von einem KI-generierten Prototypen über die Erstellung einer funktionalen Spezifikation bis hin zur Implementierungsplanung, der automatisierten Erstellung von GitHub-Issues und der orchestrierten Umsetzung durch spezialisierte KI-Agenten. Sie erfahren, wie AI Software Engineering auf Basis von Spec-Driven Development einen strukturierten Software Development Lifecycle schafft, der fachliche Anforderungen in produktionsreife Enterprise-Software überführt – bei gleichzeitiger Kontrolle über Architektur, Qualität und Implementierung.
In der ersten Demo-Session unserer Reihe „From Prototype to Production with Agentic AI“ entwickelte Martin Kaiser, Digital Product Designer bei PRODYNA, einen ersten Prototypen. Dabei folgte er demselben Vorgehen, das auch in Kundenprojekten zum Einsatz kommt: Zunächst wird die fachliche Zielsetzung verstanden und anschließend die Lösung gemeinsam und iterativ entwickelt.
Aufbauend auf diesem Prototypen entstand in der zweiten Session die technische Grundlage für alles, was in diesem Blogartikel folgt. Michael, AI Software Engineer bei PRODYNA, zeigte, wie sich individuelle KI-Agenten, die notwendige KI-Infrastruktur sowie das zugrunde liegende Framework aufbauen lassen, das wir im weiteren Verlauf für die Entwicklung der Anwendung nutzen.
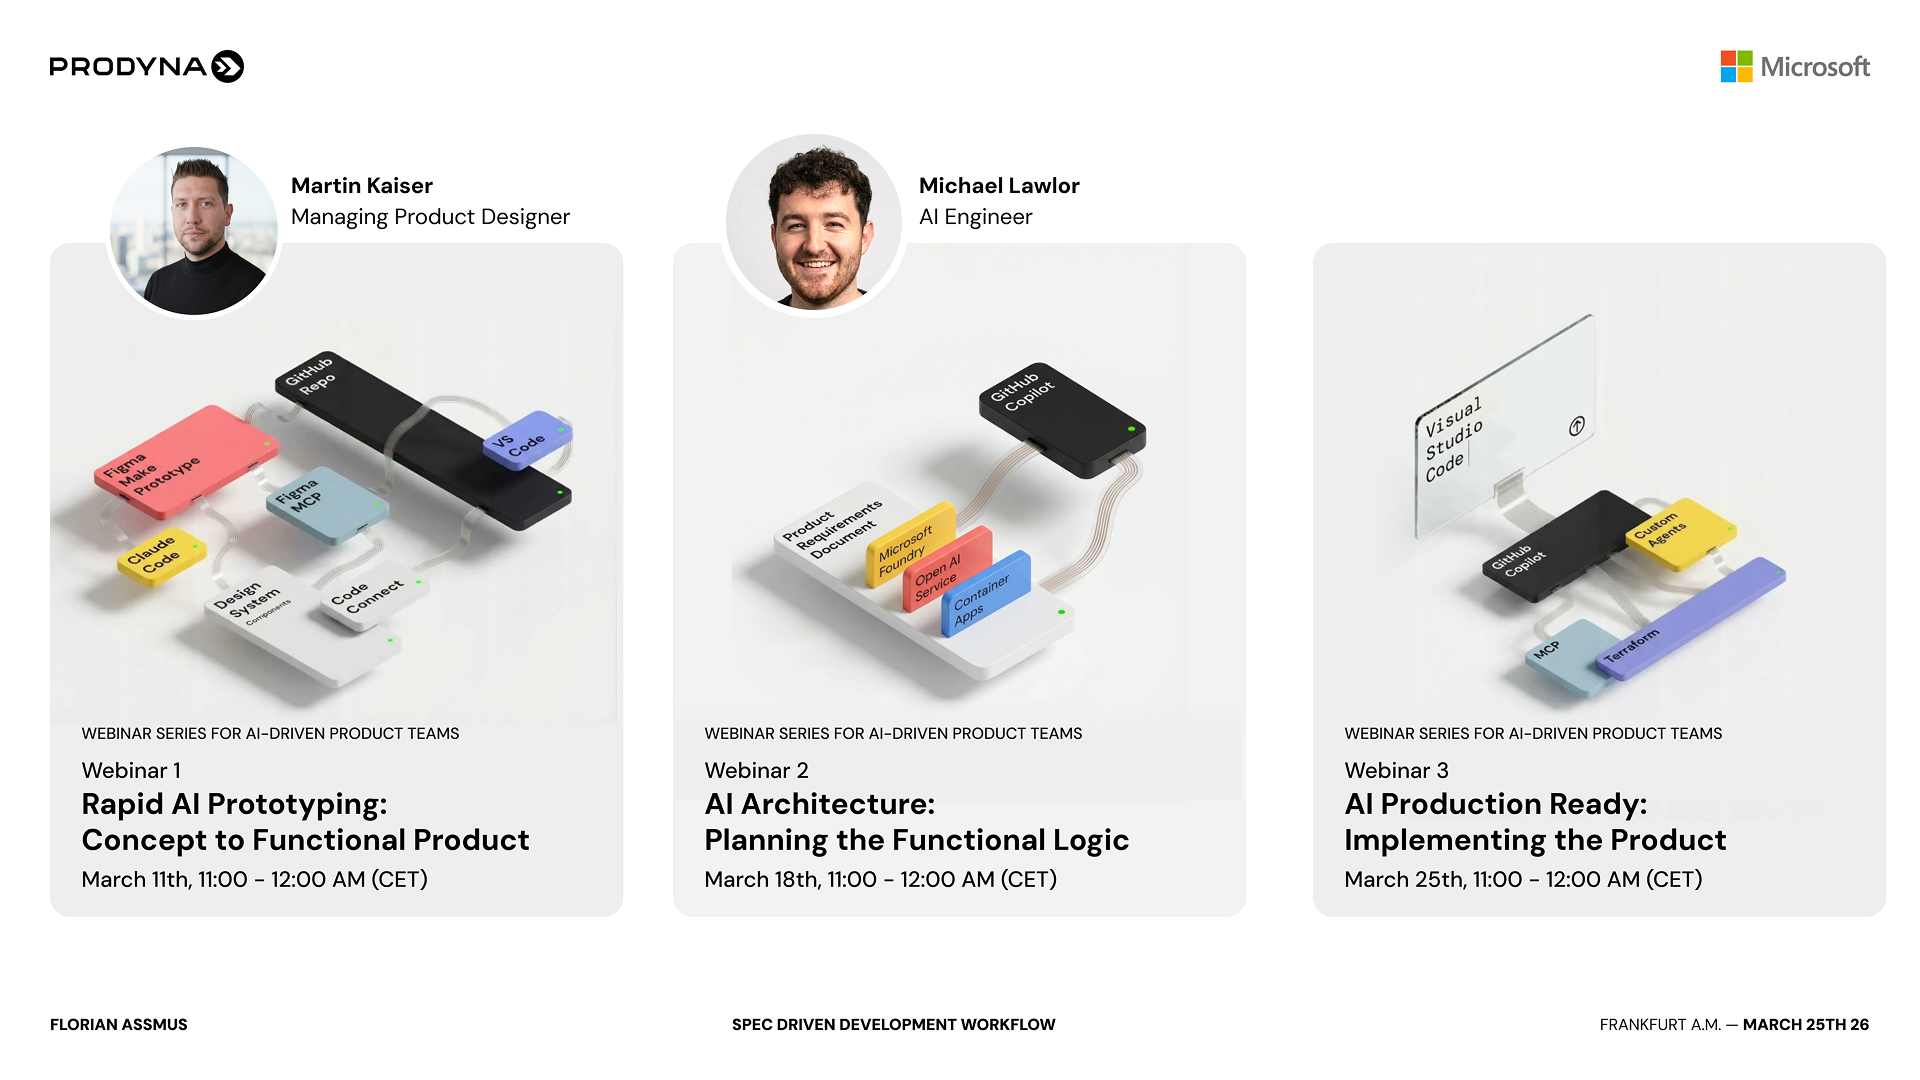
Mit dieser Basis können wir nun die entwickelten KI-Bausteine und spezialisierten Agenten einsetzen, um den Prototypen Schritt für Schritt in eine Enterprise-Anwendung zu überführen.
Der Prozess der Umwandlung des Prototyps in unternehmensgerechte Software umfasst vier Schritte.

Den Ausgangspunkt bildet der Prototyp. Er hält die fachliche Zielsetzung der Anwendung fest und macht die eigentliche Business-Intention sichtbar.
Auf Basis dieses Prototyps leiten wir anschließend die funktionale Spezifikation ab. Mithilfe von KI identifizieren wir die fachlichen Anforderungen und erstellen eine strukturierte Beschreibung dessen, was tatsächlich entwickelt werden soll.
Im nächsten Schritt planen wir die technische Umsetzung. Dazu stellen wir der KI alle relevanten technischen Informationen zur Verfügung – unter anderem den vorgesehenen Technologie-Stack, Architekturentscheidungen sowie technische Rahmenbedingungen und Einschränkungen.
Durch die Kombination aus fachlicher Zielsetzung, funktionaler Spezifikation und technischen Vorgaben entsteht ein detaillierter Implementierungsplan. Dieser wird in kleinere, klar abgegrenzte Arbeitspakete zerlegt, die später an spezialisierte KI-Agenten delegiert werden können. Genau an diesem Punkt wird AI Software Engineering zu einem strukturierten, wiederholbaren und skalierbaren Entwicklungsprozess.
Spec Driven Development
Phase 0: KI-Infrastruktur
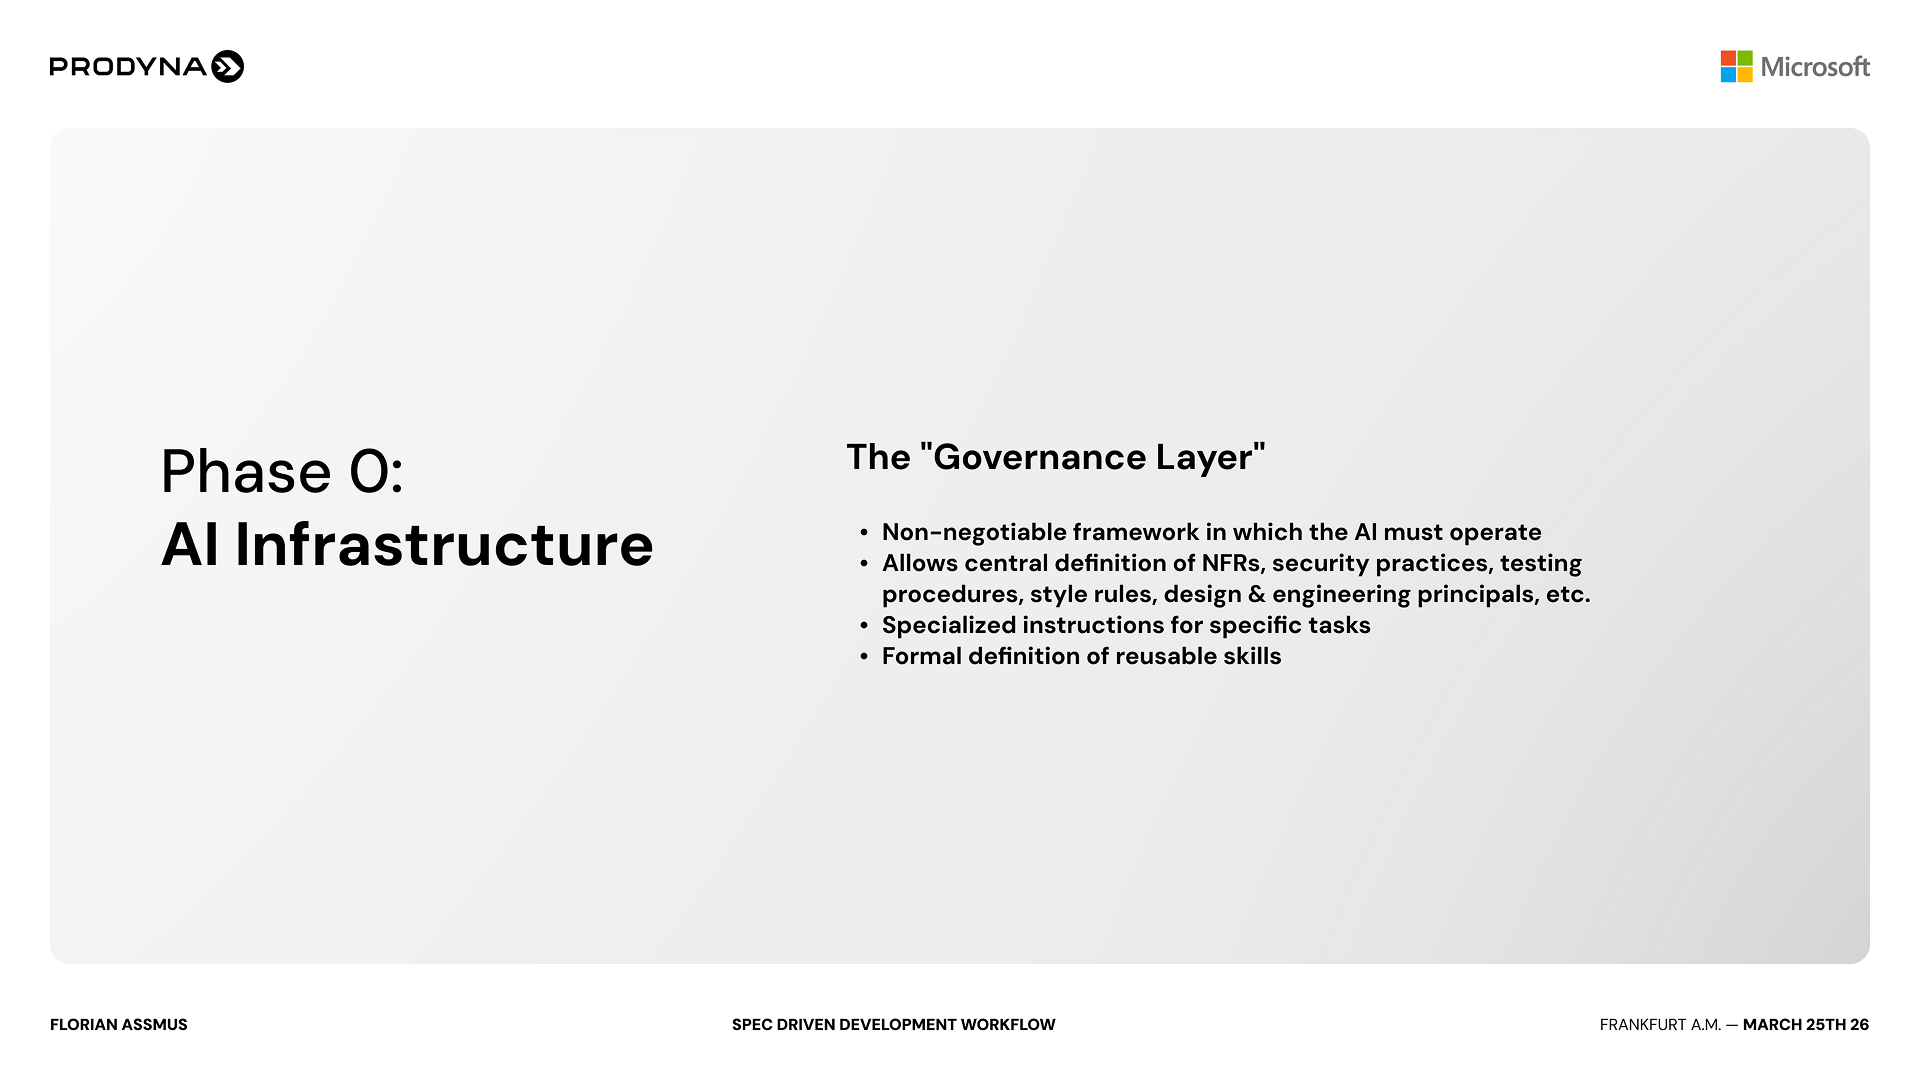
Phase 0 bildet die Governance-Ebene des Entwicklungsprozesses. Michael hat gezeigt, dass wir Copilot Custom Instructions, individuelle KI-Agenten, Hooks und Skills nutzen, um unsere Art der Softwareentwicklung abzubilden und dieses Wissen der KI zugänglich zu machen. Genau das ist die Aufgabe der Governance-Ebene.
Phase 1: Spezifikation

Im ersten Schritt stellen wir der KI unseren Prototypen sowie die User Stories zur Verfügung, die Martin während seines Prototyping-Workshops erstellt hat. Auf dieser Grundlage verdichtet die KI die fachliche Zielsetzung und leitet die eigentliche Business-Intention ab.
Der Prototyp enthält zahlreiche technische Details. Da er in kurzer Zeit entstanden ist, ist er aus Sicht der Softwareentwicklung nicht optimal strukturiert. Mithilfe von KI können wir jedoch analysieren, was tatsächlich entwickelt werden soll, und daraus eine funktionale Spezifikation ableiten.
Je präziser und vollständiger die Spezifikation ist, desto leistungsfähiger und robuster wird der gesamte KI-gestützte Softwareentwicklungsprozess.
Genau diesem Grundprinzip folgt Spec-Driven Development: Eine klar definierte Spezifikation steuert die Implementierung und dient sowohl Entwicklern als auch KI-Agenten als gemeinsame Referenz.
Im AI Software Engineering ist nicht das Prompting der entscheidende Erfolgsfaktor, sondern Präzision. Klare und eindeutige Spezifikationen reduzieren technischen Schulden, machen die Umsetzung planbarer und verbessern langfristig Wartbarkeit sowie Skalierbarkeit der Anwendung.
Phase 2: Planung und Aufgabenaufteilung

In der zweiten Phase ergänzen wir die funktionale Spezifikation um sämtliche technischen Rahmenbedingungen. Dazu gehören beispielsweise der verwendete Technologie-Stack, Architekturvorgaben sowie weitere technische Anforderungen. Auf dieser Grundlage erstellt die KI einen konkreten Implementierungsplan für die fachlichen Anforderungen.
Anschließend wird dieser Plan in kleinere, klar abgegrenzte Arbeitspakete zerlegt. Für jede Aufgabe wird ermittelt, welcher der zuvor entwickelten spezialisierten KI-Agenten am besten geeignet ist.
Michael hat bereits individuelle Agenten für die Frontend-Entwicklung, die Backend-Entwicklung sowie für die Erstellung von OpenAPI-Spezifikationen entwickelt. Jeder dieser Agenten ist auf einen klar definierten Aufgabenbereich spezialisiert und für genau diese Tätigkeiten optimiert.
Während der Planungsphase werden die einzelnen Aufgaben den passenden Spezialisten zugeordnet. Die Umsetzung erfolgt dadurch nicht durch einen allgemeinen KI-Agenten, sondern jeweils durch einen Experten für den entsprechenden Bereich.
Am Ende dieser Phase liegt eine vollständige Aufgabenliste vor. Jede Aufgabe ist einem spezialisierten KI-Agenten zugewiesen – damit ist die Grundlage für die eigentliche Implementierung geschaffen.
Phase 3: Implementierung des Produkts
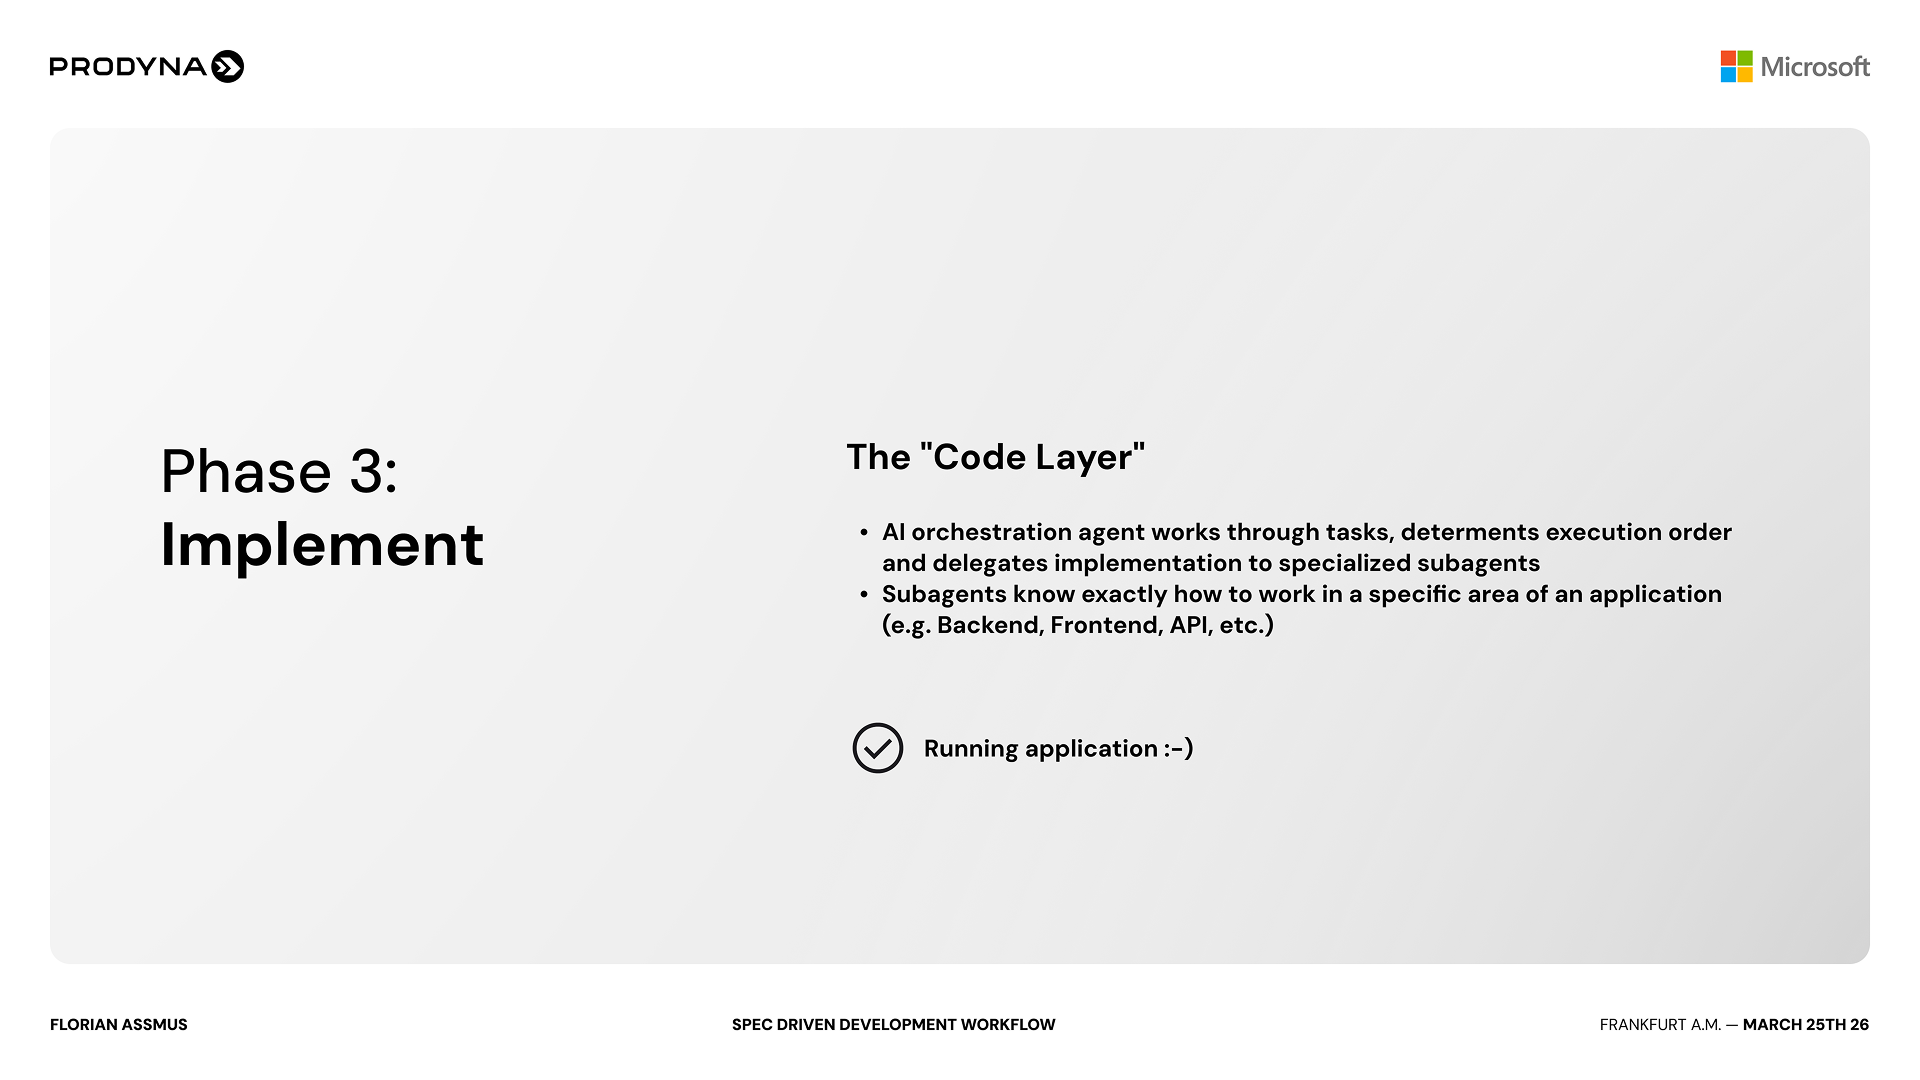
Damit gelangen wir zur letzten Phase des Prozesses. Hier übernimmt ein Orchestrierungsagent die Steuerung der Umsetzung. Er liest alle anstehenden Aufgaben ein, bringt sie in eine logische Reihenfolge und delegiert sie an die jeweils passenden Implementierungsagenten. Er hält den gesamten Prozess zusammen, koordiniert die einzelnen Sub-Agenten und stellt sicher, dass alle Aufgaben in der richtigen Reihenfolge und gemäß den definierten Vorgaben ausgeführt werden.

Der Prozess beginnt mit dem Product-Finder-Prototypen, den wir zuvor erstellt haben. Diesen übergeben wir zunächst an den Spec Agent. Der Agent erzeugt auf Basis einer vordefinierten Struktur eine Markdown-Datei, die den Aufbau unserer funktionalen Spezifikation vorgibt und die fachliche Zielsetzung der Anwendung aus dem Prototypen extrahiert.
Anschließend kommt ein weiterer spezialisierter Agent zum Einsatz, der sich in der Praxis als besonders wertvoll erwiesen hat: der Review Agent. Seine Aufgabe besteht ausschließlich darin, die erstellte funktionale Spezifikation zu prüfen. Er analysiert sie auf Konsistenz, identifiziert Lücken oder logische Unstimmigkeiten, stellt Rückfragen zur Klärung, schlägt Optimierungen vor und verfeinert die Spezifikation. Er fungiert gewissermaßen als zweite Instanz und hilft dabei, die Qualität der Anforderungen weiter zu erhöhen.
Die überprüfte Spezifikation wird anschließend an den Planning Agent übergeben. Dieser analysiert die fachlichen Anforderungen, berücksichtigt alle technischen Rahmenbedingungen sowie den vorgesehenen Technologie-Stack und erstellt daraus einen detaillierten Implementierungsplan. Anschließend zerlegt er diesen Plan in einzelne Arbeitspakete und legt für jede Aufgabe automatisch ein entsprechendes GitHub-Issue an.
Nach Abschluss der Planungsphase liegt eine vollständige Liste von GitHub-Issues vor, die sämtliche Arbeitsschritte zur Umsetzung der in der Spezifikation definierten fachlichen Anforderungen abbildet.
Im letzten Schritt übernimmt unsere Ausführungsumgebung – der Orchestration Agent. Er lädt alle GitHub-Issues einer bestimmten Funktion, bringt sie in die korrekte Reihenfolge und startet für jede Aufgabe spezialisierte Sub-Agenten, die die eigentliche Implementierung übernehmen. Jeder dieser Agenten ist Experte für seinen jeweiligen Aufgabenbereich.
Dieses Vorgehen bietet mehrere Vorteile. Einer der wichtigsten ist die Möglichkeit zur Parallelisierung. Unabhängige Aufgaben können gleichzeitig von mehreren Agenten bearbeitet werden, wodurch sich die Implementierungszeit deutlich verkürzt.
Ein weiterer entscheidender Vorteil liegt im fokussierten Kontext der einzelnen Sub-Agenten. Jeder Agent erhält ausschließlich die Informationen, die für seine konkrete Aufgabe erforderlich sind. Er kennt nicht das gesamte Projekt, sondern arbeitet mit einem klar abgegrenzten Kontext und präzisen Anweisungen. Dadurch bleibt sein Context Window auf die jeweilige Aufgabe fokussiert, was die Qualität und Konsistenz der Implementierung deutlich verbessert.
Gerade dieser fokussierte Kontext ist ein wesentlicher Erfolgsfaktor agentenbasierter Softwareentwicklung.
Wie dieser Ansatz in der Praxis funktioniert, zeigen wir nun anhand eines konkreten Beispiels in Visual Studio Code.
Die Demo-Anwendung: AI Software Engineering in der Praxis
Um den Workflow zu demonstrieren, beginnen wir mit einer einfachen Anwendung, die wir Schritt für Schritt erweitern. Die Anwendung läuft bereits und zeigt eine Liste von Produkten an.

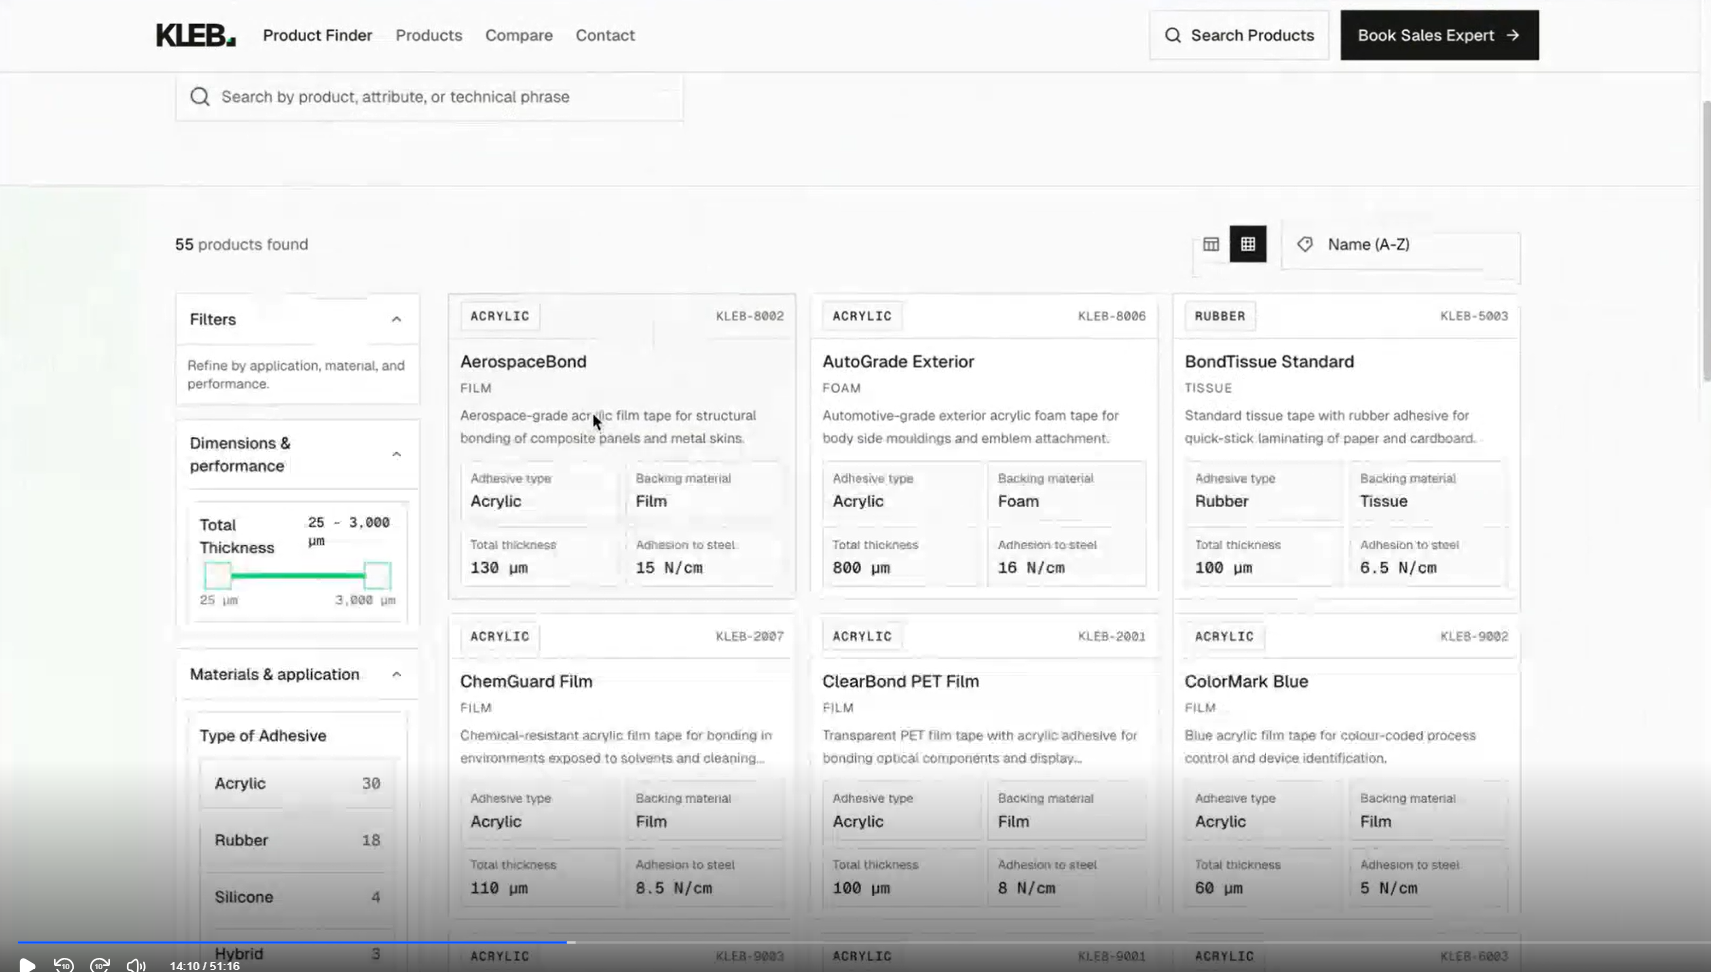
Als Beispiel dient das fiktive Unternehmen KLEB, das über ein Portfolio von rund 700 bis 800 verschiedenen Klebstoffprodukten verfügt. Die Produkte unterscheiden sich hinsichtlich ihrer Eigenschaften, Materialien und Einsatzbereiche.
Ziel ist die Entwicklung einer Expertenanwendung, mit der sich diese Produkte schnell durchsuchen, filtern und miteinander vergleichen lassen.
Zum aktuellen Zeitpunkt ist lediglich die Landingpage umgesetzt. Funktionen wie der Produktvergleich oder die Detailseiten befinden sich noch in der Implementierung.
Technisch handelt es sich bereits um eine klassische Drei-Schichten-Architektur. Das Frontend wurde als Single-Page-Application umgesetzt, das Backend basiert auf einer in Java entwickelten REST-API und wird durch eine Persistenzschicht ergänzt.
Für die lokale Entwicklung kommt SQLite zum Einsatz. Im Produktivbetrieb verwendet die Anwendung einen ORM-Mapper in Verbindung mit einer PostgreSQL-Datenbank – ein bewährter und weit verbreiteter Technologie-Stack.
Ein Blick in das Projekt zeigt, dass bereits erster Code generiert wurde.

Auch die OpenAPI-Spezifikation liegt bereits vor. Sie wurde mit demselben Prozess erstellt, den wir anschließend auch für die verbleibenden Funktionen anwenden. Die Spezifikation dient dabei nicht nur als Dokumentation, sondern bildet die Grundlage für die Implementierung – ein zentrales Prinzip von Spec-Driven Development. Die Java-Backend-Implementierung ist klar in Domänen gegliedert und entspricht den Architekturvorgaben, die in den spezialisierten KI-Agenten hinterlegt sind.
Spezialisierte KI-Agenten
Zur Erinnerung: Für die Backend-Entwicklung steht ein spezialisierter KI-Agent zur Verfügung, der auf die Entwicklung von Java-Anwendungen mit Spring Boot ausgerichtet ist.

Er arbeitet auf Basis eines klar definierten Technologie-Stacks und berücksichtigt sämtliche Architekturvorgaben sowie Entwicklungsrichtlinien für Backend, Projektstruktur und Implementierung. Diese Informationen entsprechen im Grunde einem klassischen Developer Guide. Anstatt sie jedoch ausschließlich für Entwickler bereitzustellen, haben wir sie in einem Markdown-Dokument hinterlegt, das dem Agenten jederzeit zur Verfügung steht.
Genau darin liegt einer der größten Vorteile spezialisierter KI-Agenten: Sie greifen bei jeder Aufgabe auf die Dokumentation zurück, lesen sie vollständig und wenden sie konsequent an.
Bildlich gesprochen beginnt für den Agenten jeder Arbeitstag damit, die komplette Entwicklerdokumentation erneut zu lesen. Dadurch arbeitet er stets auf Basis des aktuellen Wissensstands.
Ergänzend dazu steht ein dedizierter Frontend-Agent zur Verfügung, der nach demselben Prinzip aufgebaut ist. Er enthält sämtliche Regeln und Best Practices für die Frontend-Entwicklung.
Darüber hinaus gibt es einen spezialisierten Agenten für die Erstellung von OpenAPI-Spezifikationen. Die gemeinsame API-Spezifikation ermöglicht eine saubere Entkopplung von Frontend und Backend und bildet die vertragliche Schnittstelle zwischen beiden Komponenten.
Erstellung der funktionalen Spezifikation: Der Spec Writer Agent
Eine funktionale Spezifikation beschreibt strukturiert, was ein System leisten soll. Dazu gehören unter anderem der fachliche Umfang, beteiligte Akteure, Voraussetzungen, funktionale Anforderungen, API-Interaktionen sowie Akzeptanzkriterien – ohne dabei technische Implementierungsentscheidungen vorwegzunehmen.
Für diesen Schritt kommt unser Spec Writer Agent zum Einsatz. Seine Aufgabe besteht ausschließlich darin, funktionale Spezifikationen zu erstellen. Er erzeugt weder Code noch Tests oder andere Artefakte. Gleichzeitig weiß er genau, wo die benötigten Informationen zu finden sind, da wir ihm den Speicherort unseres Prototyp-Repositories vorgegeben haben.
In einer neuen Sitzung wählen wir den Spec Writer Agent aus und geben an, für welche Funktion eine Spezifikation erstellt werden soll.
Unser Prototyp umfasst insgesamt fünf User Stories, die als Ausgangspunkt für die Spezifikation dienen. Drei davon wurden bereits umgesetzt: die allgemeine Anwendungsstruktur und das Layout, die erweiterte Filterfunktion sowie die Produktdetailseite. Als Nächstes erstellen wir die Spezifikation für die Vergleichsfunktion.
Dazu erhält der Agent den Prompt: "Write the spec for 04-compare-feature.md".
Der Agent verbindet sich anschließend über GitHub MCP mit dem Prototyp-Repository und lädt sämtliche relevanten Informationen direkt aus GitHub. Der Prototyp muss dafür weder lokal ausgecheckt noch manuell bereitgestellt werden. Stattdessen greift der Agent über die vorhandene Tooling-Infrastruktur auf das Repository zu und sammelt automatisch alle benötigten Informationen.
Dieses Vorgehen entspricht einem typischen Szenario in Kundenprojekten. User Stories, Spezifikationen und weitere Projektdokumentationen liegen häufig in unterschiedlichen Systemen.
In unserem Beispiel stammen die Informationen aus dem Prototyp-Repository und werden über GitHub MCP abgerufen. Genauso gut könnte der Agent jedoch auf Confluence oder Jira zugreifen. Entscheidend ist lediglich, dass bekannt ist, wo die fachliche Zielsetzung dokumentiert wurde.
Der Agent erkennt daraufhin die in der ersten Session definierte Vergleichsfunktion und beginnt automatisch mit der Erstellung der funktionalen Spezifikation.
Dabei soll der Agent keine Annahmen treffen, sondern gezielt auf die vorhandenen Informationen zugreifen.
Aus diesem Grund wurde er ausdrücklich angewiesen, keine technischen Details aus den User Stories zu übernehmen. Gerade bei Figma Make enthalten diese häufig React- oder Tailwind-spezifische Informationen und vermischen funktionale mit technischen Anforderungen. Deshalb beschränkt sich der Spec Writer Agent bewusst auf die rein fachliche Beschreibung.
Die resultierende Spezifikation umfasst unter anderem die User Story, den fachlichen Umfang (In Scope und Out of Scope), die beteiligten Akteure, die Voraussetzungen sowie eine vollständige Liste funktionaler Anforderungen mit eindeutigen IDs.
Diese Struktur wurde dem Spec Writer Agent vorgegeben. Dadurch erstellt er jede Spezifikation nach demselben Schema und gewährleistet eine konsistente Dokumentation gemäß den Spezifikationsstandards von PRODYNA.
Ergänzt wird die Spezifikation durch UI-bezogene Informationen, API-Anforderungen, Interaktionsabläufe sowie Akzeptanzkriterien. Diese dienen nicht nur der Dokumentation, sondern bilden gleichzeitig die Grundlage für spätere Validierungs- und Testprozesse.
Damit liegt eine vollständige funktionale Spezifikation für die Vergleichsfunktion vor und bildet die Grundlage für die nächsten Schritte im Spec Driven Development-Prozess.
Überprüfung der Spezifikation: Der Review Agent
Sobald die funktionale Spezifikation erstellt wurde, erfolgt im nächsten Schritt ihre Überprüfung, bevor die eigentliche Implementierungsplanung beginnt.
Dafür wird der Review Agent mit dem Promt: „Review FS-04“ gestartet.
Der Agent analysiert die Spezifikation auf Konsistenz, identifiziert fehlende Informationen, logische Unstimmigkeiten und implizite Annahmen und schlägt gezielte Verbesserungen vor, bevor die Umsetzung beginnt.
Bereits im ersten Review-Durchlauf erkennt der Agent mehrere Optimierungspotenziale. Daraufhin erhält er den Prompt: „Please fix the first findings and then show me the rest.“ Der Agent arbeitet die identifizierten Punkte nacheinander ab, berücksichtigt das Feedback und überarbeitet die Spezifikation entsprechend. Nach Abschluss des Reviews weist er insgesamt zehn Findings aus: einen Blocker, fünf Major Findings und vier Minor Findings.
Sobald diese Punkte behoben wurden, ist die Spezifikation bereit für die nächste Phase – die Implementierungsplanung.
Abschließend erscheint die Meldung: „The specification is ready for implementation planning, with one action item to track.“ Die vorgeschlagene Anpassung wird übernommen und der Review-Prozess für FS-04 ist abgeschlossen.
Implementierungsplanung: Der Spec Planner Agent
Der nächste Schritt im Entwicklungsprozess ist die Implementierungsplanung. Hier kommt der Spec Planner Agent zum Einsatz. Nachdem bereits Feature Nummer zwei geplant wurde, folgt nun die Planung der Produktdetailseite. Mit dem Prompt „Plan FS-03". startet der Planner die Analyse der Spezifikation.
Der Planner analysiert die Anforderungen der Produktdetailseite und erstellt daraus einen strukturierten Implementierungsplan. Dabei identifiziert er beispielsweise notwendige Frontend-Komponenten oder neue Backend-Endpunkte, die für das Laden aller Produktdetails erforderlich sind. Anschließend zerlegt er die gesamte Umsetzung in einzelne GitHub-Issues.
Ein agentischer Implementierungsplan beschreibt die Entwicklung als logisch aufeinander aufbauende, testbare Arbeitspakete. Jedes Arbeitspaket wird einem spezialisierten KI-Agenten zugewiesen und enthält klare Abnahmekriterien sowie definierte Abhängigkeiten.
Bereits im Vorfeld wurden verschiedene Implementierungsphasen für den Planner Agent definiert. Auf dieser Grundlage erstellt der Planner nun sämtliche Aufgaben und organisiert sie systematisch in mehreren Phasen.
Zuvor habe ich einige Implementierungsphasen für den Planer-Agenten definiert:
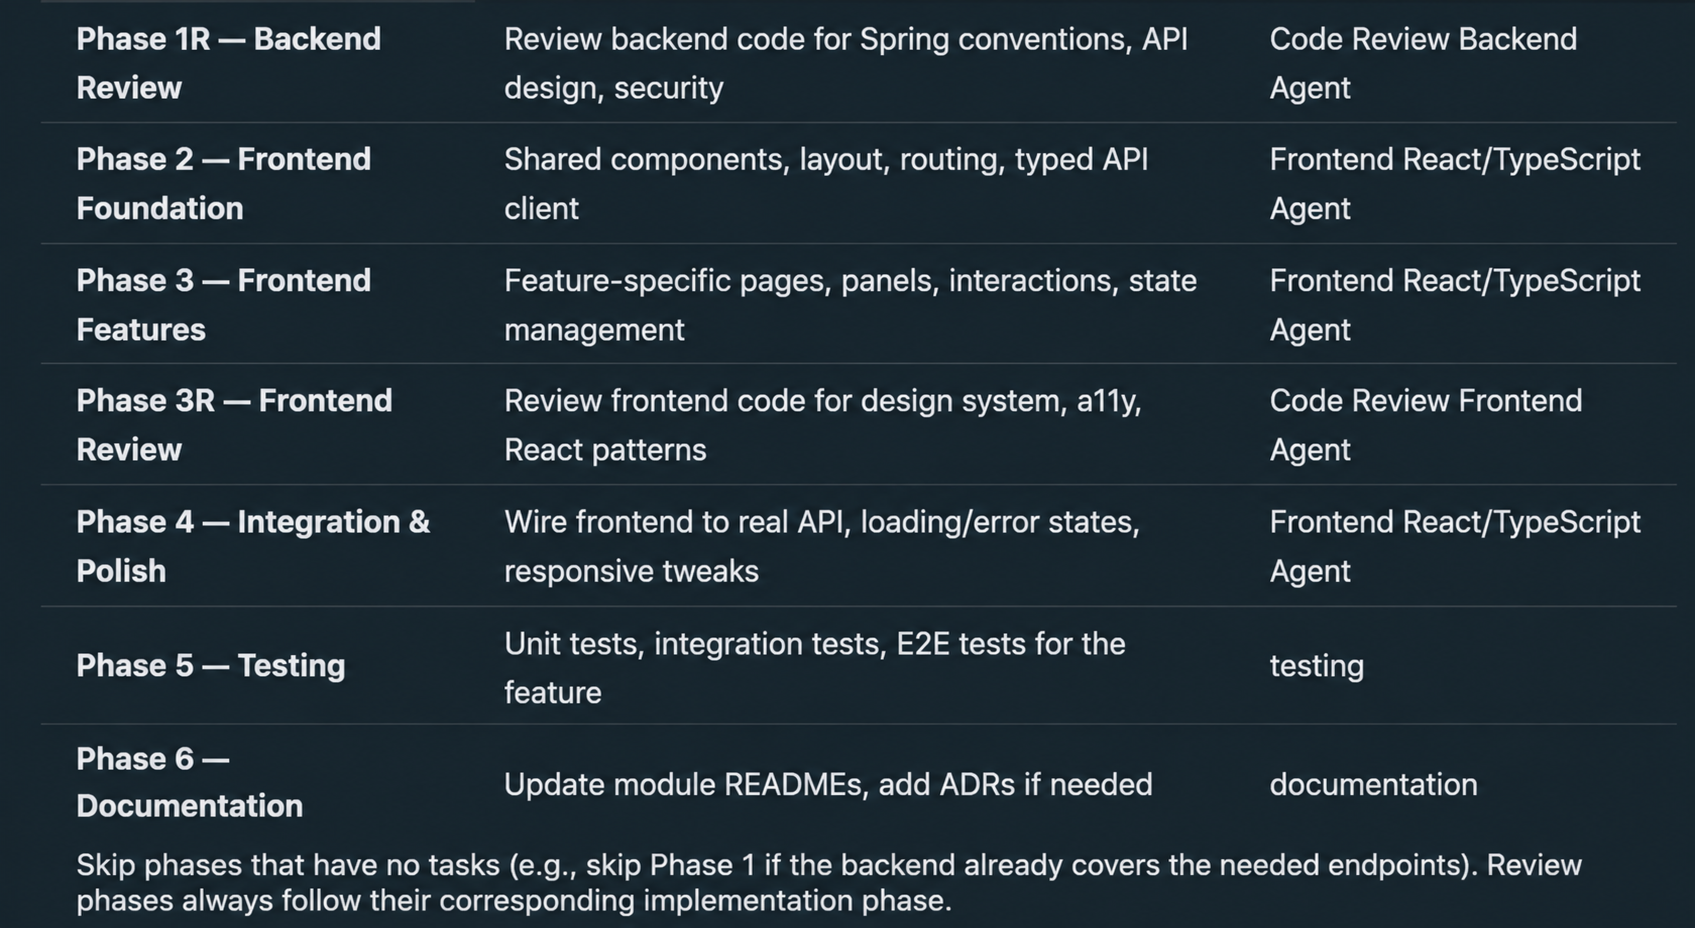
Dies ist der allgemeine Implementierungsprozess.
Der Planer wird nun die Spezifikation durchgehen, die Umsetzungsaufgaben festlegen und diese in verschiedene Phasen einteilen.
Die erste Phase umfasst die API-Entwicklung. Darauf folgt die Backend-Implementierung. Nach Abschluss der Entwicklung schließen Review- und Qualitätssicherungsaufgaben den Prozess ab. Für jede Aufgabe wird außerdem festgelegt, welcher spezialisierte Agent die Umsetzung übernimmt.
Abschließend erstellt der Planner automatisch alle erforderlichen GitHub-Issues und erzeugt damit einen vollständigen Umsetzungsplan.
Im dargestellten Beispiel entstehen 21 Aufgaben in acht Implementierungsphasen, die vollständig mit GitHub synchronisiert werden.
Der Planner bestätigt anschließend: „21 Aufgaben in 8 Phasen, vollständig mit GitHub-Issues synchronisiert. Der Plan ist bereit für die Ausführung durch den Spec Executor Agent (FS-03)."
Umsetzung der Implementierung mit dem Spec Executor Agent
Die eigentliche Implementierung erfolgt nicht improvisiert, sondern auf Basis eines klar definierten Plans.
Dazu wird eine neue Sitzung mit dem Spec Executo Agent gestartet und der Prompt: „Implement FS-02“ übergeben.
Der Agent lädt zunächst sämtliche GitHub-Issues, die zu dieser Spezifikation gehören.
Anschließend analysiert der Spec Executor die optimale Reihenfolge der Umsetzung. Im Beispiel erkennt er, dass zunächst die grundlegenden Frontend-Komponenten entwickelt werden müssen, bevor die weiteren Implementierungsaufgaben beginnen können.
Sobald diese Reihenfolge feststeht, startet die eigentliche Umsetzung der Spezifikation.
Spezialisierte KI-Agenten im Einsatz
Der Orchestrierungs-Agent erhält die Anweisung: „Nachdem alle GitHub-Issues geladen wurden, starte für jede Aufgabe einen eigenen Sub-Agenten“ Genau dieser Prozess wird anschließend automatisch ausgeführt. Jede einzelne Aufgabe erhält ihren eigenen spezialisierten KI-Agenten.
Dabei kann jeder Agent mit dem Modell arbeiten, das für seine jeweilige Aufgabe am besten geeignet ist.
Dadurch lassen sich spezialisierte Agenten gezielt mit KI-Modellen kombinieren, die ihre jeweilige Aufgabe besonders effizient lösen.
Anstatt alle Anforderungen gleichzeitig zu bearbeiten, konzentriert sich jeder Agent ausschließlich auf ein klar definiertes Problem.
Beispielsweise eignen sich GPT-5 Codex-Modelle hervorragend für klar strukturierte Implementierungsaufgaben. Sie arbeiten zielgerichtet und bleiben konsequent auf die definierte Aufgabe fokussiert.
Opus-Modelle, insbesondere Opus 4.6, verfügen dagegen über ausgeprägte kreative Fähigkeiten. Deshalb eignen sie sich besonders für die Erstellung und Ausarbeitung funktionaler Spezifikationen. So kann für jeden Agenten das jeweils optimale KI-Modell ausgewählt werden.
Während sich jeder spezialisierte Agent ausschließlich auf seine Aufgabe konzentriert, übernimmt der Orchestrierungs-Agent die Koordination des gesamten Entwicklungsprozesses. Dadurch bleibt die Implementierung jederzeit strukturiert, konsistent und beliebig skalierbar.
Je nach Umfang der Anforderungen kann dieser Prozess einige Zeit in Anspruch nehmen – in komplexen Projekten sogar mehrere Stunden. Am Ende steht jedoch ein vollständig lauffähiges Softwareprodukt.
Skalierbare Softwareentwicklung mit Agentic Software Development
Der gesamte Entwicklungsprozess beginnt mit einem KI-generierten Prototypen. Aus ersten Ideen, Skizzen oder Wireframes entsteht innerhalb kurzer Zeit ein funktionsfähiger Prototyp.
Im nächsten Schritt wird die KI-Infrastruktur aufgebaut – das sogenannte AI Operating System. Es besteht aus individuell entwickelten KI-Agenten, Governance-Regeln sowie wiederverwendbaren KI-Komponenten.
Darauf aufbauend wird die fachliche Anforderung in funktionale Spezifikationen überführt, überprüft, optimiert und anschließend in einen detaillierten Implementierungsplan übersetzt. Daraus entstehen automatisch GitHub-Issues, deren Umsetzung anschließend durch spezialisierte KI-Agenten orchestriert wird.
Dieser durchgängige Prozess zeigt, wie Spec-Driven Development die Grundlage für einen strukturierten, KI-gestützten Software Development Lifecycle bildet. Unternehmen erhalten damit einen standardisierten Ansatz, um Enterprise-Software konsistent, skalierbar und langfristig wartbar zu entwickeln.
Ein strukturierter Entwicklungsprozess bietet dabei zahlreiche Vorteile:
- Nachvollziehbare Anforderungen durch klar definierte Spezifikationen mit Umfang und Akzeptanzkriterien.
- Weniger Überraschungen während der Implementierung durch frühzeitige Reviews.
- Einheitliche Architekturstandards durch spezialisierte Agenten mit klaren Verantwortlichkeiten.
- Schnellere Entwicklungszyklen durch Delegation und parallele Ausführung von Aufgaben.
- Höhere Zuverlässigkeit durch Orchestrierung und integrierte Qualitätskontrollen.
Der größte Vorteil besteht jedoch darin, dass ein wiederholbarer Weg vom ersten Prototyp bis zum Enterprise-Produkt entsteht. Anstatt erfolgreiche Prototypen jedes Mal manuell neu zu entwickeln, wird der gesamte Prozess standardisiert und automatisiert.
Künstliche Intelligenz beschleunigt die Softwareentwicklung erheblich. Unternehmensreife Software entsteht jedoch erst durch einen disziplinierten Entwicklungsprozess. Anforderungen müssen strukturiert erfasst, validiert, geplant und über klar definierte Schnittstellen umgesetzt werden. Der hier beschriebene agentische Entwicklungsprozess – Prototyp → Funktionale Spezifikation → Review → Implementierungsplanung → Orchestrierte Umsetzung – macht KI nicht nur zu einem Werkzeug, sondern zu einem integralen Bestandteil eines professionellen Softwareentwicklungsprozesses.
Die wichtigste Erkenntnis lautet: Erfolgreiche KI-gestützte Softwareentwicklung basiert auf Orchestrierung – nicht auf Improvisation. Wer fachliche Anforderungen in KI-lesbare Spezifikationen überführt und die Umsetzung an spezialisierte, kontextbezogene Agenten delegiert, verlässt sich nicht mehr auf zufällige Modellantworten. Stattdessen entsteht ein planbarer Engineering-Prozess, der reproduzierbare Ergebnisse liefert.
Agentic Software Development bedeutet letztlich, jedem KI-Agenten eine klar definierte Verantwortung innerhalb eines strukturierten Entwicklungsprozesses zu geben. So entsteht Software vorhersehbar, konsistent und in der Qualität, die moderne Enterprise-Anwendungen erfordern.


Weitere verwandte Themen
Schnelle KI-Prototypenentwicklung: Von der Idee bis zum marktreifen Produkt
Erfahren Sie, wie Rapid AI Prototyping die Entwicklung von KI-Produkten beschleunigt, indem Geschäftsanforderungen vom ersten Tag an in funktionsfähige, validierte Prototypen umgesetzt werden.
Mehr lesen
Architektur & Funktionale Logik: Der Übergang vom Prototyp zu einer sicheren Enterprise-Architektur
Wie überführen wir dieses Konzept verantwortungsvoll in ein skalierbares, produktionsreifes System
Mehr lesen